El auge de la inteligencia artificial ha traído a nuestras páginas web nuevos visitantes: crawlers que recopilan contenido para entrenar modelos de IA y asistentes que leen una página en nombre de un usuario.
Se suman a los de siempre: buscadores, herramientas de monitorización, scrapers y bots que buscan vulnerabilidades. Todo esto se traduce en más tráfico, más consumo de recursos y logs cada vez más grandes. Ya te hablamos de los crawlers de IA en este artículo.
La analítica web no ve a la mayoría de estos visitantes, porque no ejecutan JavaScript. Donde sí quedan es en el log de acceso del servidor. En este artículo vamos a construir una pequeña prueba de concepto que lee el log de acceso de Apache o Nginx, agrupa las peticiones por visitante, pedirle a Jev que clasifique a cada uno y muestre el resumen en una interfaz de terminal hecha con el nuevo componente TUI de Symfony.
¿Qué es Jev?
Jev es el primer modelo «System One» de TypeSafe AI, que lo lanzó en acceso anticipado el 15 de septiembre de 2026. A diferencia de un LLM, Jev no genera texto: recibe un estado (tus datos, en texto o en JSON), una serie de preguntas tipadas y devuelve decisiones estructuradas con sus probabilidades, listas para usar en tu código sin tener que interpretar ninguna respuesta.
Las preguntas se construyen a partir de tres primitivas:
- choice: elige una opción de una lista. Devuelve la opción elegida, la probabilidad de cada una y una confianza.
- noul: indica si una afirmación es cierta, con un valor entre 0 y 1.
- score: puntúa el estado en una escala ordenada de niveles.
En una misma petición puedes mezclar varias preguntas. Se evalúan en paralelo y por separado, así que añadir preguntas no añade latencia a la petición. TypeSafe afirma una latencia muy baja y publica un coste por millón de tokens de entrada de unos pocos céntimos, con la salida gratis (probablemente porque la respuesta no es texto generado token a token, sino unas pocas probabilidades).
Su documentación da algunos consejos que vamos a seguir:
- Dejar en el código todo lo que se pueda calcular.
- Añadir una opción other por si la lista no cubre todos los casos y, ante una respuesta poco segura, preguntar a una persona en vez de actuar.
- Además, escribiremos las preguntas en inglés, el idioma en el que mejor funciona según una guía no oficial.
¿Qué es Symfony TUI?
TUI es un componente nuevo de Symfony 8.1 que permite construir interfaces de terminal a pantalla completa: aplicaciones que se redibujan en el sitio y reaccionan a cada tecla, como un visor de logs o un panel interactivo. No sustituye a Console, pues este se sigue encargando de los comandos, los argumentos y la salida, y TUI, de los widgets, el layout, los estilos y el teclado.
Trae widgets de texto, listas seleccionables, editores, barras de progreso y Markdown, y estilos con una sintaxis parecida a CSS: bordes, márgenes interiores, colores y paneles en horizontal.
Todo funciona con eventos, sobre Fibers y el event loop de Revolt, y necesita PHP 8.4.1 o superior. Incluye además un terminal virtual con el que podemos probar la pantalla desde PHPUnit.
Hay que tener presente que es un componente experimental: su API puede cambiar de una versión a otra.
Creando la prueba de concepto
En nuestro caso, vamos a crear un comando de consola, app:traffic-summary, que usa Console, HttpClient y TUI sin el resto del framework de Symfony.
Para realizar la prueba, hemos generado un log sintético representativo del tráfico de un día normal para una web WordPress.
- Cada línea del log se convierte en una entrada con la IP, la fecha, el método, la ruta, el código de respuesta, el referer y el user agent.
- La query string se descarta en ese mismo momento, por privacidad.
- Después agrupamos las peticiones por visitante (IP y user agent) y las describimos con palabras.
Lo mismo hacemos con el ritmo entre páginas:
- La proporción de CSS, JavaScript e imágenes, los códigos de respuesta o si ha pedido el robots.txt.
- El resultado es el estado que recibe Jev: un JSON con una clave visitor que contiene esa descripción y una muestra de rutas. La IP no se envía nunca.
- A cada visitante le hacemos tres preguntas en una sola petición, una por primitiva: qué tipo de cliente es, si dice ser un navegador pero se comporta como un bot y qué riesgo supone para la web (como se muestra en la captura, extraído del código):
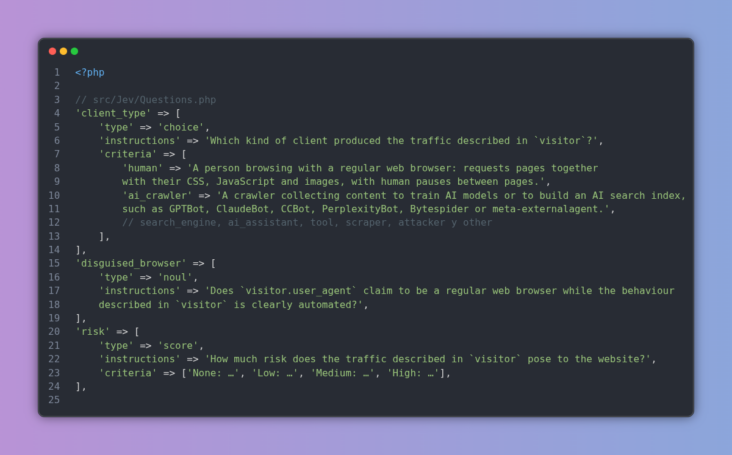
- Jev no ve las claves de las preguntas (client_type, risk…), solo sus instrucciones y criterios, así que cada una tiene que entenderse por sí sola. Por eso merece la pena dedicar tiempo a redactarlas.
- Con las comillas invertidas apuntamos a un campo concreto del estado, como visitor.user_agent.
- Esta es una parte de la respuesta real para un scraper que se hacía pasar por Chrome: unas 300 páginas en cinco minutos, sin pedir CSS, JavaScript ni imágenes.
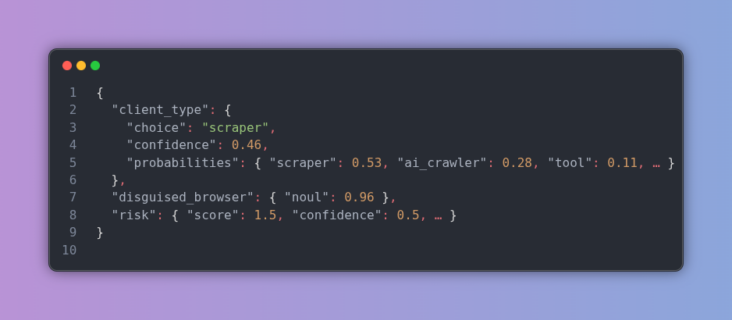
Jev acierta la categoría (scraper, con un 0.53) y detecta el engaño (0,96), pero no está seguro: su confianza es de 0,46. Si la confianza de client_type queda por debajo de 0,5, el visitante va a una categoría «Revisar» que no es una opción de Jev: la decide el código.
Lanzamos las peticiones en bloques de ocho, que se ejecutan en paralelo, y guardamos las respuestas en una caché para no pagar dos veces por lo mismo: si alguna petición falla o volvemos a lanzar el comando, solo se piden las que faltan.
El resultado
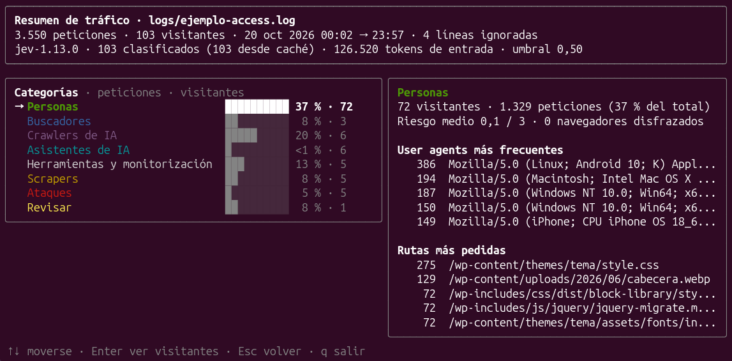
Como se puede observar, la pantalla permite recorrer de forma interactiva las categorías del panel izquierdo, y el panel derecho muestra el detalle de la categoría seleccionada.
Esto podría ser particularmente útil si lo lanzáramos en un proceso que leyese los logs de forma continua, e incluso que nos avisase por algún canal (Telegram, Discord, Slack) cuando, con una nueva pregunta a Jev, un visitante resultase ser una amenaza que deberíamos revisar.
Con el log de ejemplo, de 103 visitantes, Jev colocó a 102 en la categoría que les corresponde en 4,2 segundos, con 126.520 tokens de entrada (menos de un céntimo).
Detectó también al atacante que se hacía pasar por Chrome. El único que fue a «Revisar» es el scraper que hemos seguido: en otras llamadas con los mismos datos, su confianza fue de 0,49 y 0,50, así que un caso en el límite puede caer a cualquier lado del umbral.
Conclusiones
Jev encaja bien en este tipo de problema: el código reúne los hechos, Jev los juzga y devuelve decisiones tipadas que podemos filtrar, ordenar y comparar con un umbral, sin interpretar texto.
Nos permite tener un filtrado en tiempo real (que para nuestra prueba de concepto es suficiente habiendo clasificado 103 registros en 4.2s). Aun así, hay que tener claras las limitaciones:
- No sustituye a un WAF: clasificar tráfico es una heurística, no una medida activa de seguridad. Además, cambiar el user agent es una técnica habitual entre los atacantes.
- Fiabilidad: nos da una primera clasificación de cuáles son las potenciales amenazas, pero puede haber falsos positivos y falsos negativos, como la persona real que salió como scraper. La confianza ayuda, pero no lo detecta todo.
- Coste: clasificar un día de tráfico sintético de una web pequeña costó menos de un céntimo. Se hace una petición por visitante (unos 1.200 tokens de entrada), así que el coste crece con el número de visitantes distintos: con mil webs como esta, serían unos 5 $ al día.
Si quieres profundizar en este tema, te invitamos a que consultes la documentación de Jev y la documentación de TUI.