


Durante años, hablar de rastreo en una web era hablar, sobre todo, de Googlebot. Revisábamos el robots.txt, analizábamos los logs y comprobábamos que Google pudiera llegar correctamente a las páginas importantes.
Eso ha cambiado.
Hoy una web puede recibir visitas automatizadas de OpenAI, Anthropic, Perplexity, Google y muchos otros servicios. Y lo importante es que no todos vienen a hacer lo mismo.
Algunos rastrean contenido para utilizarlo en resultados de búsqueda. Otros recopilan información que puede utilizarse para entrenar modelos. Y otros acceden a una página concreta porque una persona acaba de pedírselo a su asistente.
Por eso, la pregunta ya no es simplemente ¿quiero que la IA rastree mi web?.
La pregunta es:
¿Qué tipo de IA quiero que acceda a mi web y para qué?
No todos los crawlers de IA son iguales
Uno de los errores más habituales es tratar todos los bots de IA como un único tipo de visitante.
Cloudflare los clasifica actualmente según tres comportamientos: Search, Agent y Training. No es un estándar universal, pero sí una división útil para entender qué estamos permitiendo o bloqueando.
1. Crawlers de búsqueda
Su función es recopilar o indexar contenido para utilizarlo posteriormente al responder consultas.
OpenAI utiliza OAI-SearchBot para sus funciones de búsqueda en ChatGPT. Si una web lo bloquea, sus páginas no aparecerán en los resultados de búsqueda de ChatGPT. Anthropic dispone de Claude-SearchBot para sus funciones de búsqueda web.
2. Crawlers de entrenamiento
Aquí el objetivo es diferente: recopilar contenido que pueda utilizarse para entrenar o mejorar modelos.
En OpenAI, ese papel corresponde a GPTBot. En Anthropic, a ClaudeBot. Ambos proveedores permiten controlar estos robots de forma independiente de sus crawlers de búsqueda.
Así, por ejemplo, podemos permitir la búsqueda y bloquear el entrenamiento.
Más información: OpenAI – Anthropic
3. Agentes o accesos iniciados por el usuario
El tercer caso es diferente.
Aquí no necesariamente tenemos un crawler recorriendo la web. Un asistente puede acceder a una URL concreta porque una persona le ha pedido que consulte esa página.
OpenAI identifica estas peticiones mediante ChatGPT-User y Anthropic mediante Claude-User. OpenAI aclara que, al tratarse de acciones iniciadas por el usuario, las reglas de robots.txt pueden no aplicarse de la misma forma que a sus crawlers automáticos.
No es lo mismo que un agente que actúa dentro de tu web. Si usas WordPress, en nuestro artículo sobre la IA en WordPress explicamos cómo, mediante MCP, un agente puede interactuar con la instalación según los permisos definidos. Aquí nos centramos únicamente en quién puede acceder y leer tu contenido.
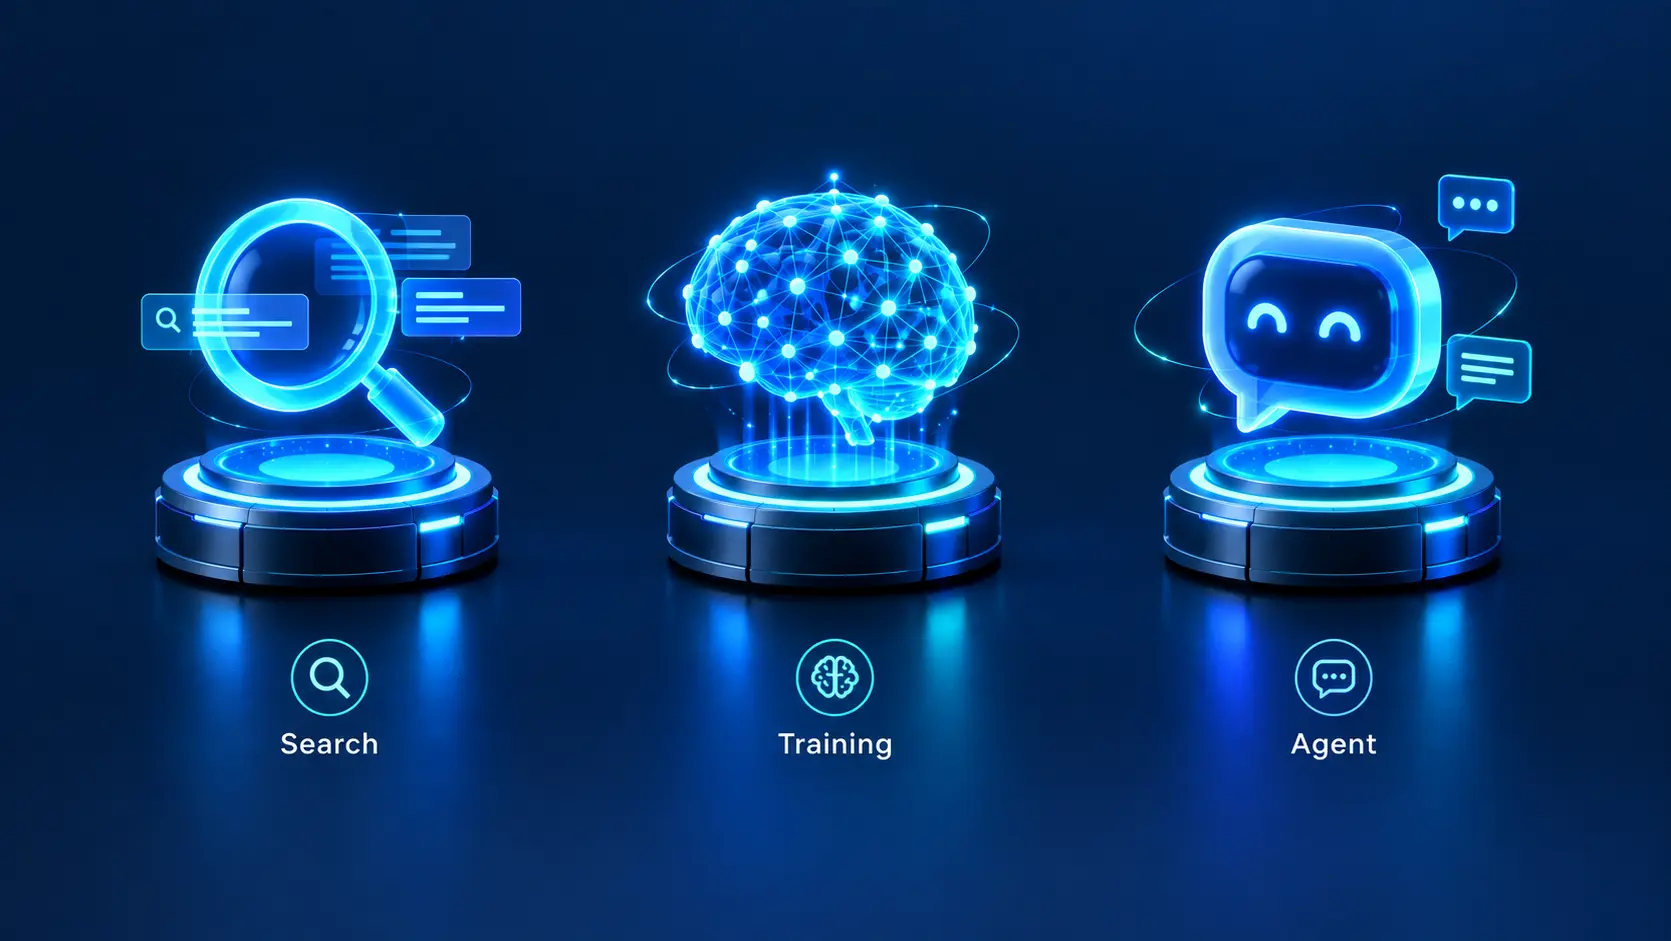
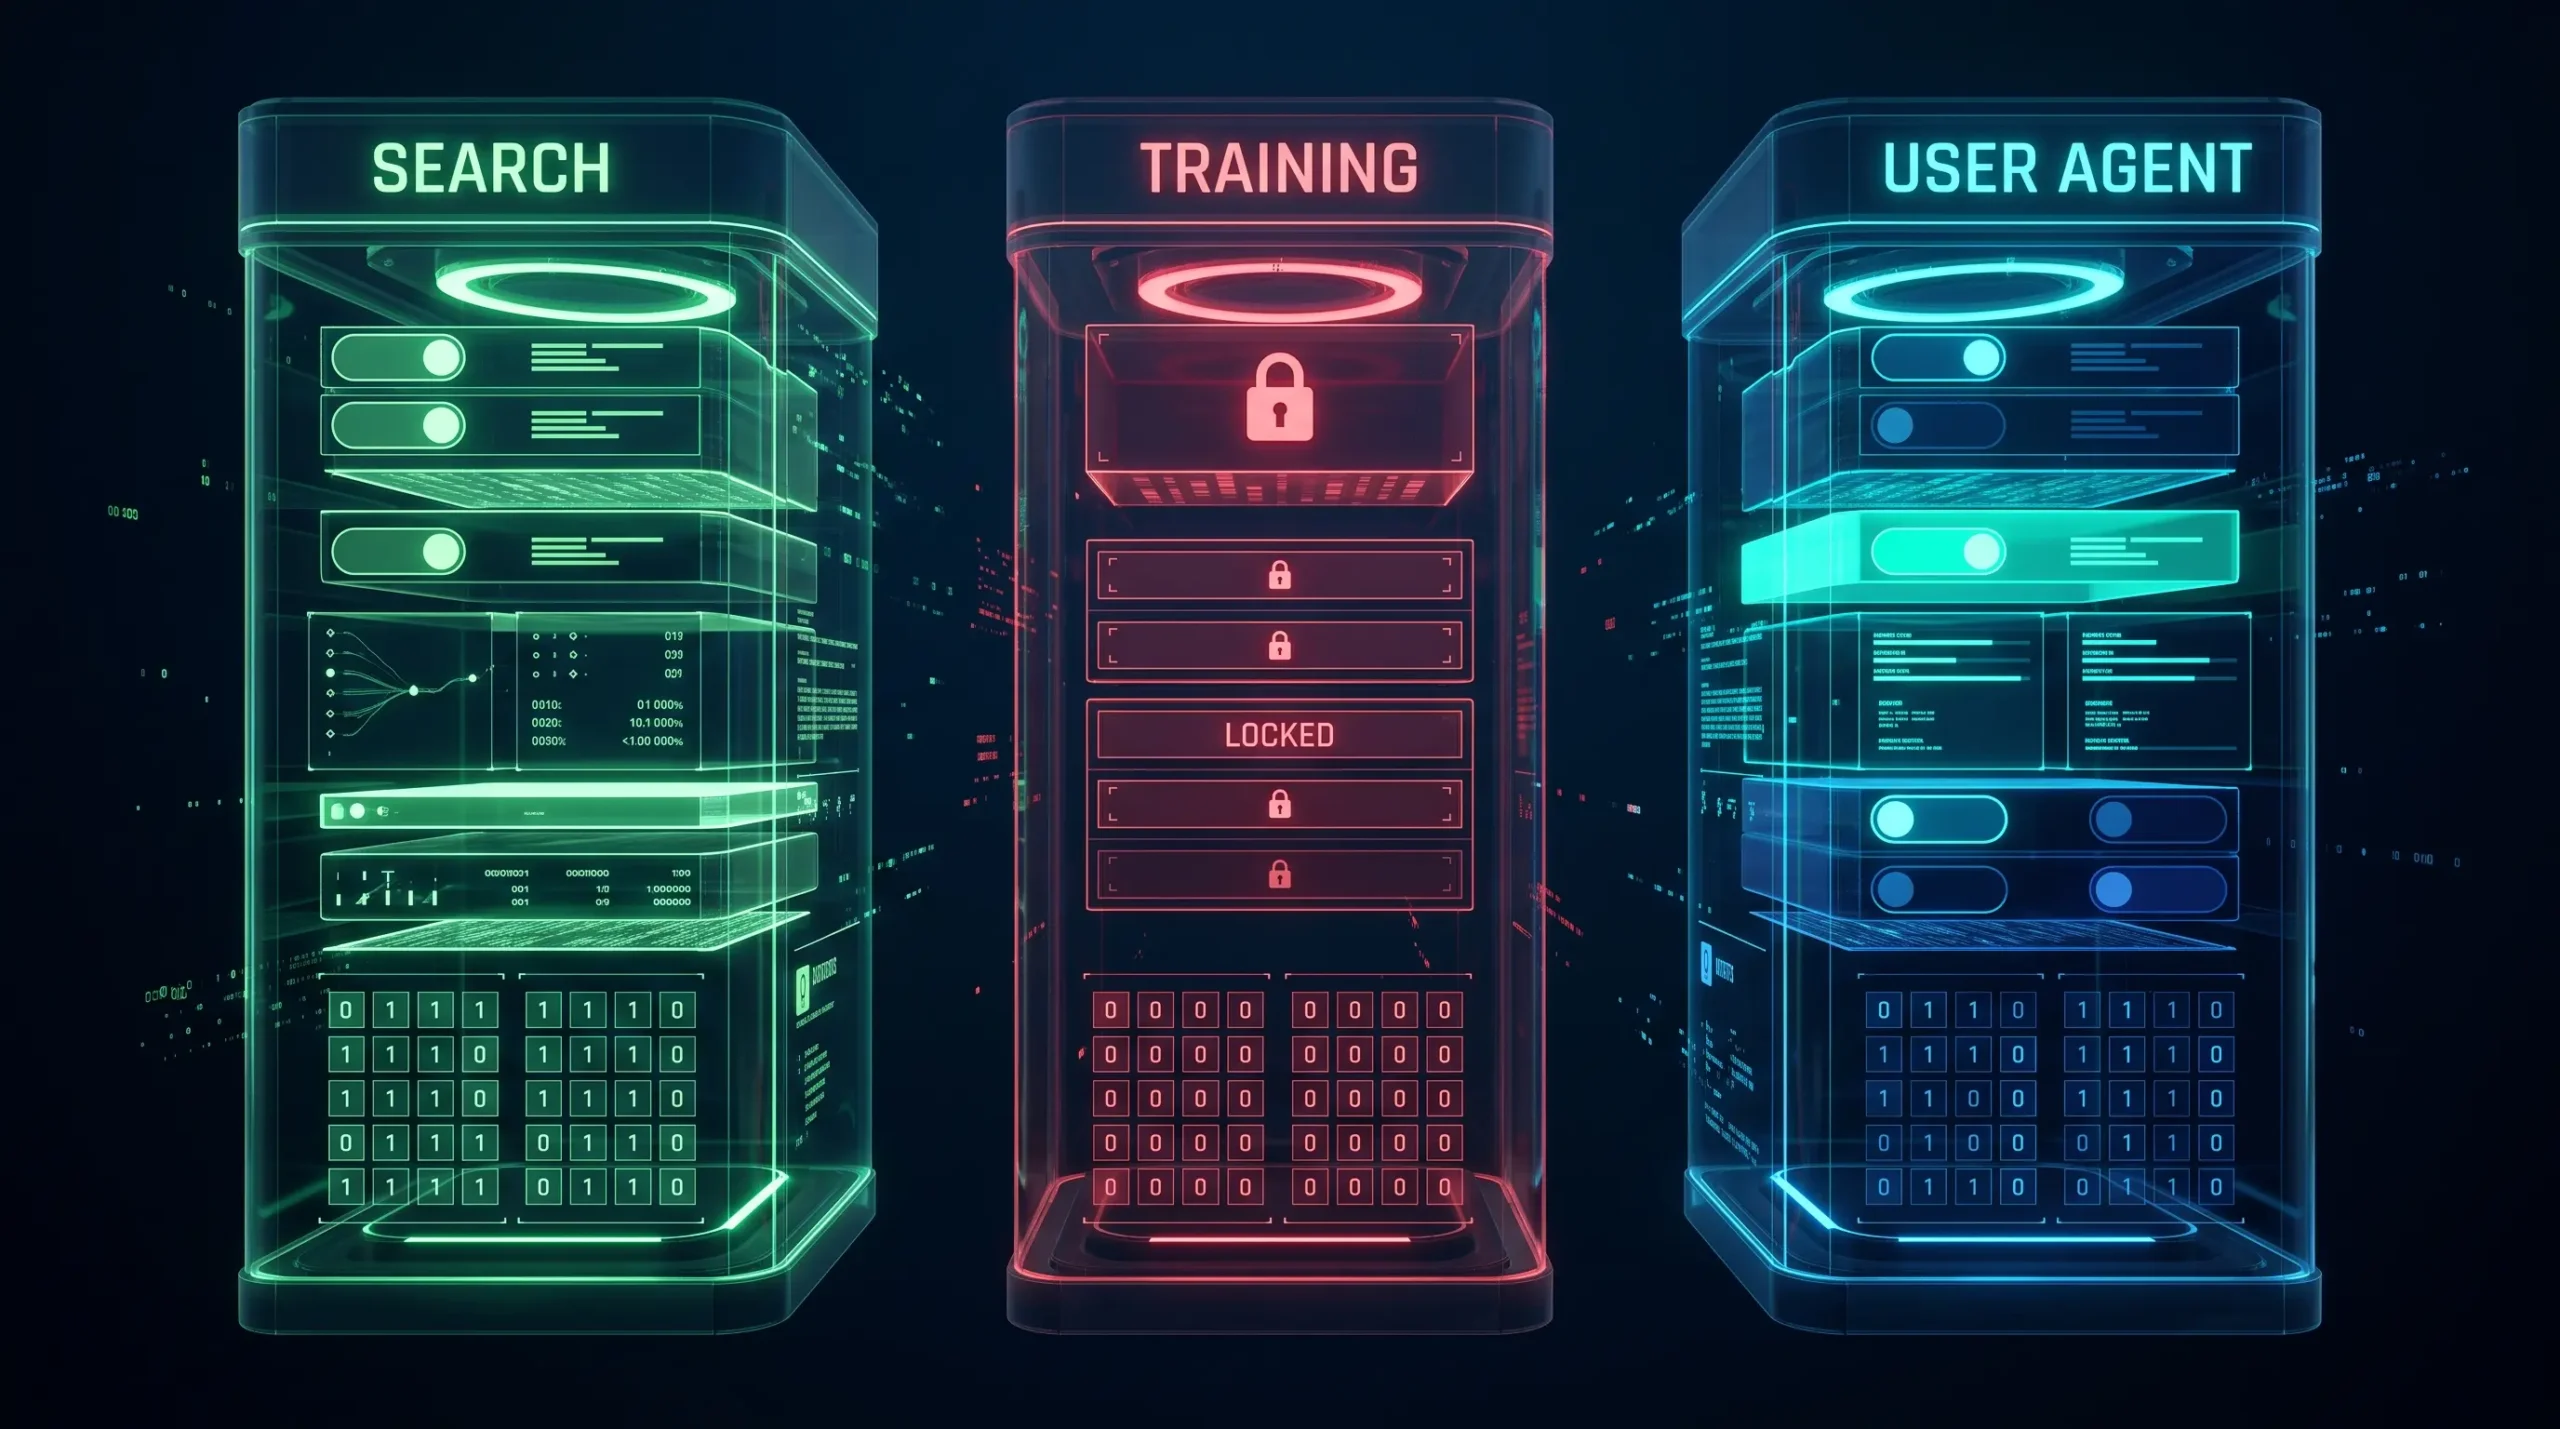
Esto deja tres decisiones diferentes: permitir búsqueda, permitir entrenamiento y permitir accesos iniciados por usuarios.
Entonces, ¿qué pongo en mi robots.txt?
El archivo robots.txt sigue siendo una de las principales herramientas para indicar a los crawlers qué partes de una web pueden rastrear.
Por ejemplo, una configuración podría permitir los crawlers de búsqueda de OpenAI y Anthropic, pero bloquear los destinados a entrenamiento:
User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /
No conviene copiar esta configuración como una receta universal: la decisión depende del negocio, del valor del contenido y de la visibilidad que queramos conseguir.
Además, hay varios matices importantes.
robots.txt no es un cortafuegos. Es una indicación que los crawlers que respetan el protocolo deben seguir. Un bot malicioso puede ignorarla.
Tampoco controla la indexación. Bloquear el rastreo de una URL no equivale a eliminarla de un índice. En Google, el control de rastreo y el de indexación son mecanismos diferentes.
Y ChatGPT-User no se comporta necesariamente como un crawler convencional: OpenAI advierte de que robots.txt puede no aplicarse a determinadas peticiones iniciadas por usuarios.
La capa que muchas auditorías pasan por alto: el CDN
Podemos tener un robots.txt perfectamente configurado y, aun así, estar bloqueando bots en otro punto de la infraestructura.
Si una web utiliza Cloudflare, dispone de AI Crawl Control, una herramienta que permite identificar qué crawlers de IA están accediendo al dominio y establecer reglas específicas para cada uno.
Desde el 15 de septiembre de 2026, Cloudflare aplica nuevos valores predeterminados a los nuevos dominios que se incorporan a su plataforma: los bots clasificados como Training o Agent se bloquean en páginas que muestran publicidad, mientras que los de Search permanecen permitidos. Cloudflare también indica que los crawlers de propósito mixto que combinan Search y Training pueden verse afectados por las políticas de bloqueo del entrenamiento.
Esto no significa que todas las webs que utilizan Cloudflare estén bloqueando automáticamente todos los bots de IA. Pero sí que la configuración del CDN forma parte de la auditoría.
Además, las reglas del WAF pueden interferir con estas políticas, por lo que hay que revisar ambas capas.
En otras palabras: robots.txt, CDN, WAF y servidor pueden estar tomando decisiones diferentes sobre la misma petición.
Más información: Cloudflare sobre el control de crawlers de IA
¿Quién está visitando realmente tu web?
Aquí vuelven a cobrar protagonismo los logs del servidor.
Los registros permiten saber qué user-agent realiza una petición, qué URL solicita, con qué frecuencia y qué respuesta recibe.
Podemos encontrarnos nombres como:
GPTBot
OAI-SearchBot
ClaudeBot
Claude-SearchBot
ChatGPT-User
Claude-User
PerplexityBot
Pero cuidado: el user-agent se puede falsificar.
Un bot malicioso puede identificarse como GPTBot sin ser de OpenAI. Cuando una decisión de bloqueo sea importante, conviene verificar el origen mediante las IP o mecanismos publicados por el propio proveedor.
Por eso, analizar solo el nombre del bot no siempre es suficiente.
Y si no tenemos acceso a los logs, cualquier decisión sobre este tráfico se toma prácticamente a ciegas.
Google tiene sus propias reglas
Con Google aparece otra fuente habitual de confusión: Google-Extended.
No es un crawler independiente que sustituya a Googlebot. Es un token de robots.txt que actúa como mecanismo de control sobre determinados usos del contenido rastreado por Google.
Google indica que Google-Extended permite gestionar si el contenido puede utilizarse para entrenar futuras generaciones de modelos Gemini y para determinados casos de grounding. Al mismo tiempo, no afecta a la inclusión de una web en Google Search ni es una señal de posicionamiento.
Por tanto, no debemos confundir Google-Extended con un mecanismo para desaparecer de AI Overviews o AI Mode.
Para esas experiencias Google ha introducido otro control específico en Search Console. Google ha desplegado mundialmente el control de IA generativa de la Búsqueda, que permite gestionar la inclusión de una propiedad en determinadas funciones generativas como AI Overviews y AI Mode. Este control es independiente de Google-Extended y no afecta al posicionamiento fuera de esas experiencias ni al entrenamiento de modelos.
Search Console también incorpora un informe de rendimiento para estas funciones, con datos como impresiones por página, país, dispositivo y evolución temporal. Su disponibilidad puede depender de que la propiedad tenga suficientes datos.
Puedes consultar la documentación de Google sobre sus crawlers y controles relacionados con IA y la información de Search Console sobre las experiencias de IA en Search para ampliar estos puntos.
La diferencia es importante:
Google-Extended controla determinados usos del contenido por parte de Google.
Search Console gestiona la inclusión en determinadas experiencias generativas de Search.
Una decisión distinta para cada negocio
No existe una configuración universal que podamos aplicar a cualquier web.
Un ecommerce puede querer mantener abiertos los crawlers de búsqueda para aparecer en nuevas superficies y, al mismo tiempo, limitar el rastreo destinado a entrenamiento. Una empresa de servicios puede considerar importante que sus contenidos aparezcan en respuestas generativas, mientras que una web cuyo contenido tenga un alto valor editorial puede establecer una política diferente.
Por eso, antes de crear reglas conviene responder a tres preguntas:
¿Queremos que los asistentes puedan encontrar nuestro contenido?
¿Queremos que puedan acceder a él cuando un usuario lo solicite?
¿Queremos permitir que ese contenido se utilice para entrenar modelos?
Las respuestas no tienen por qué coincidir.
La parte técnica consiste después en trasladar esas decisiones a cada capa de la infraestructura y comprobar que realmente se están aplicando.
¿Qué debería revisar una web hoy?
No existe una configuración universal. Pero una auditoría puede empezar por seis pasos:
- Identificar quién rastrea la web. Revisa los logs y busca crawlers de IA reales.
- Clasificar cada bot. Diferencia entre búsqueda, entrenamiento y accesos iniciados por usuarios.
- Definir una política. Decide qué quieres permitir y qué quieres bloquear.
- Revisar el robots.txt. Configura reglas específicas para los principales crawlers.
- Revisar CDN, WAF y servidor. Comprueba que no existan reglas que contradigan esa política.
- Medir antes de excluir. Consulta Search Console para conocer la visibilidad actual en las experiencias generativas de Google.
El objetivo no debería ser bloquear la inteligencia artificial por defecto.
Tampoco abrirle la puerta a todo.
Se trata de algo mucho más concreto: saber quién está accediendo a nuestra web, qué quiere hacer con nuestro contenido y qué nivel de acceso tiene sentido para nuestro negocio.
El SEO técnico ya no consiste únicamente en preparar una web para que Googlebot pueda rastrearla. También implica entender cómo los nuevos sistemas de búsqueda, los modelos de IA y los agentes interactúan con nuestra infraestructura.
Y, antes de decidir quién puede entrar en nuestra web, quizá debamos empezar por una pregunta muy sencilla:
¿Quién está llamando a la puerta?
En acceseo combinamos SEO técnico y desarrollo para analizar estos problemas desde las distintas capas de una web, desde robots.txt y logs hasta servidor, CDN y WAF.
